 davpirelli
«Quindi l'hai fatto fare tutto all'AI?»
No. E la risposta lunga è molto più interessante di quella corta.
SassoGo è online da due mesi. Sono 1.034 sassi registrati, 264 persone iscritte, 2.392 tappe di viaggio tracciate e poco più di 51.000 chilometri percorsi da pietre dipinte che passano di mano in mano. Il primo sasso (il mio) è stato registrato il 20 luglio 2026. Non avevo un piano di marketing, non ho speso un euro in pubblicità.
La prima versione funzionante (flusso completo, mappa, email, autenticazione) l'ho messa online in tre giorni. Senza AI ci avrei messo probabilmente 1/2 mesi. Ma il punto di questo articolo è che quei mesi non sarebbero stati mesi di pensiero: sarebbero stati mesi di digitazione. E la differenza è tutto.
L'esigenza: un gioco analogico senza memoria
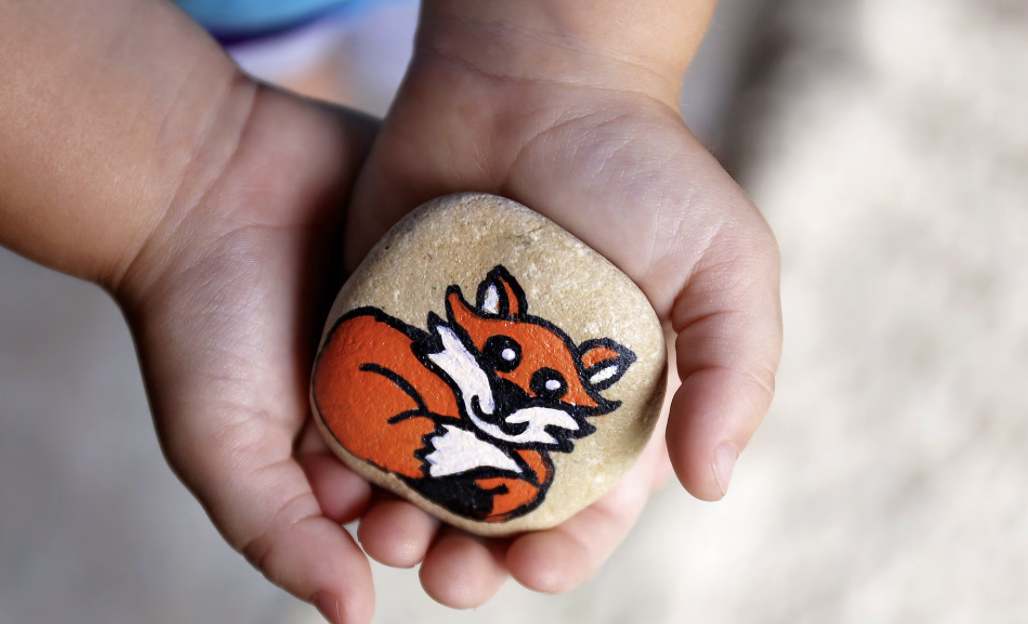
Esiste un fenomeno che in Italia chiamiamo "sassi dipinti", altrove rock hunting o painted rocks. Le persone dipingono un sasso, lo lasciano su una panchina, su un muretto, sul davanzale di una fontana. Qualcuno lo trova, se lo tiene o lo riposiziona da un'altra parte. È bellissimo, costa zero ed è completamente analogico.
Il problema è che il sasso non ha memoria. Lo dipingi, lo lasci, e finisce. Qualcuno lo raccoglie a duecento chilometri di distanza e tu non lo saprai mai.
La parte più affascinante (il viaggio) è esattamente la parte che va perduta. I gruppi Facebook provano a colmare il vuoto con le foto, ma è un rimedio peggiore del male: il sasso lo devi cercare tra i post, il post si perde nel feed, e chi trova un sasso quasi mai è iscritto al gruppo giusto. Da qui l'idea: dare al sasso un diario di bordo. Un codice scritto dietro, una mappa pubblica, e ogni tappa registrata da chi lo trova.
Fin qui è solo un'idea e le idee (per quanto buone) da sole non servono a niente. Quello che conta è la parte successiva.
Prima il pensiero, poi il prompt
La cosa che ho fatto per prima non è stata aprire un editor. È stata disegnare il modello dei dati. Su carta.
E la decisione centrale (quella che ha determinato tutto il resto del progetto) è stata questa: lo stato del sasso e la sua storia sono due cose diverse.
Sembra banale. Non lo è. La scelta ingenua sarebbe stata una tabella sassi con sopra latitudine, longitudine, ultimo_trovatore, data_ultimo_ritrovamento.
Funziona il primo giorno e ti condanna per sempre: il viaggio non lo puoi ricostruire, perché ogni ritrovamento sovrascrive il precedente. La struttura che ho scelto è a due tabelle:
rocks— un record per sasso. Chi l'ha creato, la foto, lo stato attuale. Lo stato risponde a una sola domanda: dove sta ora?rock_events— un record per tappa. Tipo di evento (created, dropped, found, rehidden, kept), coordinate, foto, nota, firma del finder. Gli eventi rispondono a un'altra domanda: cos'è successo?
La sequenza cronologica degli eventi georeferenziati è la traccia sulla mappa. Non c'è un campo "percorso" da tenere aggiornato: la polyline è una SELECT x ORDER BY created_at. Quando due mesi dopo ho voluto la classifica dei sassi che avevano percorso più km, non ho dovuto migrare niente: i dati c'erano già, perché la struttura era giusta prima che servisse.
Questa decisione l'ho presa io, ragionandoci per 30 minuti, con una penna in mano. Nessun modello me l'avrebbe suggerita, perché nessun modello sapeva che due mesi dopo avrei voluto le classifiche.
La seconda decisione: il codice è la prova fisica
Secondo problema di progettazione, e questo è di "sicurezza". Se il sasso ha un codice e il codice sta nell'URL, chiunque può falsificare un ritrovamento dal divano. Addio. Il gioco è morto il giorno stesso. Anche qui, l’AI mi aveva proposto di usare il codice univoco del sasso per vedere il diario. Non avrebbe funzionato. Quindi il sasso ha due chiavi distinte, e questa separazione l l’AI non c’è arrivata:
code— segreto. Quattro caratteri stampati dietro il sasso, su un alfabeto che esclude i caratteri ambigui (niente0/O, niente1/I, perché qualcuno li scriverà a mano con un pennarello). Non compare mai in una pagina pubblica, in un URL, nel JSON della mappa o nella sitemap. È nascosto perfino nelle serializzazioni del model. Il suo unico scopo è dimostrare che hai il sasso in mano.public_slug— pubblico, tipogufo-blu-4f2a. Derivato dal titolo più un suffisso casuale, scollegato dal codice. È questa la chiave che finisce negli URL del diario e della mappa.
Il risultato è che il diario di ogni sasso è completamente pubblico..puoi leggere tutto il viaggio, vedere le foto, seguirne le tappe, ma non puoi inventarti una tappa, perché per registrare un'azione devi digitare quattro caratteri che esistono solo sull'oggetto fisico. Il lookup è sotto rate limit (10 tentativi al minuto) per scoraggiare chi volesse provarli tutti.
Questo è design di dominio. È la parte che nessuno vede e che decide se il prodotto sta in piedi.
La terza decisione: il finder non si registra mai
L'ultima scelta strutturale, e per me la più importante dal punto di vista del prodotto. Il momento del ritrovamento è il punto di massimo attrito dell'intero sistema. Una persona sta camminando, trova un sasso colorato, lo gira, legge un indirizzo e un codice. In quel momento hai forse trenta secondi della sua attenzione. Se le chiedi di registrarsi, di confermare una email, di scaricare un'app..beh..l'hai persa. Non è un'ipotesi, è come funzionano le persone, e anche questo, l'AI non lo sà.
Quindi: chi trova un sasso non ha un account e non ne avrà mai uno. Inserisce il codice, dà l'OK alla geolocalizzazione, carica una foto se vuole, e ha finito. È identificato da un token anonimo in un cookie. Solo chi crea i sassi ha un account, perché quella è una persona già motivata che si è seduta a dipingere per mezz'ora.
Tre decisioni: separazione stato/eventi, doppia chiave pubblica/segreta, finder sempre guest. Tutte prese prima di scrivere una riga di codice. Tutte "farina del mio sacco" e dell’esperienza che ho maturato facendo R&D in O&DS.
Poi il documento, e solo dopo l'AI
Quello che ho fatto dopo il foglio di carta è stato scrivere un file MD. Non un prompt: un documento di progetto. Il modello di dominio, gli stati e le transizioni ammesse, i cinque passi del flusso utente, lo stack tecnico, le convenzioni di codice, le cose da non fare. È questo il passaggio che quasi nessuno racconta quando parla di sviluppo con l'AI, ed è quello che fa la differenza tra un prototipo e un prodotto. Un modello linguistico è bravissimo a scrivere codice e pessimo a decidere (per ora, se non istruito bene). Se gli dici "fammi un sito per sassi dipinti" ti restituisce qualcosa che compila, che sembra funzionare, e che è strutturalmente sbagliato in tre punti che scoprirai tra sei settimane.
Se invece gli dai un documento che dice "gli stati sono questi cinque, le transizioni sono queste, il codice non deve mai comparire in un URL, niente componenti Blade, Bootstrap 5 e Bootstrap Icons, mai emoji, mai stili inline, usa scss ecc.." allora sì, diventa velocissimo.
La regola che ho applicato: io decido l'architettura, l'AI scrive l'implementazione. Non è un compromesso, è una divisione del lavoro che rispecchia dove sta effettivamente il valore. Lo scaffolding è andato via in poche ore: migrazioni, model, relazioni, controller, le viste Blade di base, l'autenticazione custom. Tutto il lavoro meccanico, quello che conosco a memoria e che mi costa solo tempo di battitura, l'ho delegato.
Il risultato del primo giorno era già un ciclo di vita completo e testato end-to-end: registrazione, creazione sasso con foto compressa, rilascio con GPS, ritrovamento da guest, riposizionamento con tracciato a tre punti, Milano→Torino→Genova, e chiusura con il sasso tenuto in collezione.
Le cose che ho dovuto fare a mano
Qui arriva la parte onesta. Perché il racconto "ho scritto un prompt ed è uscito un prodotto" è marketing, non ingegneria.
Il problema della doppia compressione
Le foto arrivano da smartphone: 5-10 MB l'una. Su VPS il disco si riempie in una settimana. Quindi ho scritto il PhotoService: ridimensiona al lato lungo di
800px, JPEG a qualità 60, correzione dell'orientamento EXIF. Poi ho aggiunto una compressione anche lato browser, per non far aspettare chi ha il 3G in mezzo a un parco o un bosco. E qui è comparso un bug che nessun test avrebbe preso: le foto arrivavano visibilmente sgranate. Il motivo è che comprimere due volte a qualità 60 non dà qualità 60. Dà molto peggio: il secondo passaggio ricomprime artefatti già presenti, amplificandoli. La soluzione è che il JS usa la stessa dimensione del server (letta da una costante pubblica, così non possono divergere) ma comprime a qualità 92 — solo per accorciare l'upload. La compressione vera avviene una volta sola, lato server.
Non è una cosa che un modello ti dice spontaneamente. È una cosa che vedi perché guardi la foto sul telefono e pensi "questa è brutta", e poi sai dove andare a cercare.
Il problema che arriva alla terza settimana
C'è un momento preciso in cui un progetto smette di essere un progetto e diventa una cosa di cui sei responsabile. Per me è arrivato dopo circa tre settimane. Finché sei a venti sassi e cinque utenti, la moderazione la fai guardando. Apri l'admin la sera, leggi le descrizioni nuove, guardi le foto, e stai tranquillo.
È esattamente quello che ho fatto per le prime settimane, e funzionava. Poi la community ha iniziato a crescere davvero — dieci-venti sassi nuovi al giorno, commenti, note dei trovatori — e mi sono ritrovato con un problema che non è tecnico ma di tempo: ogni contenuto caricato da uno sconosciuto è pubblico da subito, con una foto, su una mappa che usano anche le famiglie con i bambini. Non posso essere io il collo di bottiglia, e non posso nemmeno lasciare che le cose passino senza che nessuno le guardi.
Le due soluzioni standard sono entrambe sbagliate. La pre-moderazione umana (niente è pubblico finché non approvo) uccide il gioco: il bello è lasciare un sasso e vederlo comparire sulla mappa, non aspettare che il signor Davide si svegli. La moderazione a posteriori lascia contenuti potenzialmente offensivi online per ore. Quindi ho costruito un terzo percorso, e l'ho fatto con n8n, di cui ho già scritto in un altro articolo.
Come funziona
L'architettura è volutamente in due pezzi separati, e la separazione è la parte importante. Il sito notifica, non decide. Ogni azione rilevante come "sasso creato", "commento pubblicato", "ritrovamento registrato", "utente iscritto" ecc parte come evento verso un webhook admin unico:
È un POST JSON best-effort: timeout di tre secondi, nessuna eccezione propagata. Se n8n è giù, o lento, o l'ho rotto io mentre ci lavoro, l'utente non se ne accorge nemmeno. n sistema di moderazione che può impedire a una persona di pubblicare un sasso perché un servizio esterno non risponde è un sistema peggiore del problema che risolve. E nel payload il codice segreto del sasso non entra mai — nemmeno lì.
N8N giudica. Il workflow riceve l'evento e manda il materiale a un modello: per un sasso nuovo, la foto più titolo e descrizione; per un commento o una nota di ritrovamento, il testo. Il prompt non chiede "è bello?", chiede se viola le linee guida: contenuti offensivi, sessualmente espliciti, politici, insulti, dati personali di terzi.
Poi n8n richiama il sito. E qui sta il pezzo che all'inizio mi mancava: per un po' il flusso sapeva giudicare (avvisandomi su Telegram) ma non poteva agire. Ho aggiunto un piccolo gruppo di endpoint dedicati:
Le tre decisioni che contano
Il flusso n8n si costruisce in un pomeriggio. Le decisioni che lo rendono utilizzabile in produzione, no.
1. L'oscuramento non cancella niente. Quando un contenuto viene moderato non si tocca il testo: si scrive moderated_at e moderation_reason, e un accessor sul model mostra l'avviso al posto dell'originale. Il testo vero resta nel database.
Pensa alla nota di Barbara sull'ospedale. Un classificatore un po' zelante può marcare "malattia, contenuto sensibile" e oscurare la cosa più bella che sia successa quel giorno sul sito. Se l'oscuramento fosse distruttivo, quel testo sarebbe perso per sempre.
2. Il filtro sta nel model, non nelle view. La nota di un ritrovamento esce da cinque posti diversi: diario pubblico, feed attività, due Resource dell'API per l'app nativa, in admin...Filtrare in ognuno significa cinque modifiche oggi e una dimenticanza al primo punto nuovo, con un buco che scopri quando il testo offensivo è di nuovo pubblico. Quindi c'è un trait Moderatable: il filtro è sull'accessor, e chi legge il model legge già il testo giusto. Per l'admin e per i form di modifica c'è un rawText() esplicito.
3. I tipi moderabili sono una whitelist. Il tipo arriva dall'URL. Risolverlo in un nome di classe calcolato darebbe a chi chiama la possibilità di puntare a model che non c'entrano nulla. Quindi:
Fuori da questa lista restano di proposito i messaggi privati fra utenti. Moderarli significherebbe leggere corrispondenza privata, e quella è una decisione di prodotto — non un'estensione tecnica della lista. Aggiungere una riga sarebbe banale. Il punto è che non va aggiunta.
Quanto ha lavorato, davvero
Va detto con onestà, perché è la parte che nei post su questi argomenti sparisce sempre: il sistema ha oscurato pochissimo, forse anche per la natura del progetto eh. Un sasso bloccato, due nota oscurata, zero commenti. Questo non significa che sia stato tempo sprecato — significa che la community si comporta bene, il che è una notizia molto migliore. Il valore non è nel volume di contenuti bloccati: è nel fatto che adesso non devo essere io a guardare, e che se arriva qualcosa di brutto di notte non resta online fino al mattino dopo.
È un presidio, non un filtro industriale. Ma è la differenza tra un progetto che puoi far crescere e uno che devi sorvegliare.
Stony, ovvero quando l'AI entra nel prodotto
Con la moderazione l'AI lavora dietro le quinte: giudica, e l'utente non la vede mai. Con Stony invece ci parla direttamente. È un chatbot, ed è il punto in cui l'AI smette di essere uno strumento mio e diventa una funzionalità del prodotto.
Non è un wrapper su un modello. È un piccolo agente con tool calling costruito ad hoc: quando un utente chiede "quanti sassi ci sono in Veneto?", il modello non prova a indovinare, chiama uno strumento che interroga il database e riceve dati veri. E qui c'è un bug che vale la pena raccontare perché è istruttivo su come si sbagliano queste cose. Il tool (che ho fatto scrivere completamente a Claude) aveva un limite: massimo sei sassi in elenco, per non saturare il contesto. Sensato. Solo che il modello contava le righe che riceveva e rispondeva serenamente "in Veneto ci sono 6 sassi", quando erano 69 (e qui, mi sono accorto io, ipotizzando il motivo per cui succedeva).
La correzione è di una riga di concetto: l'elenco troncato deve sempre essere accompagnato dal totale reale. Il modello non deve dedurre dai dati, deve leggere il numero. Lo scrivo perché è esattamente il tipo di errore che caratterizza i sistemi basati su LLM: non crashano. Rispondono. Con sicurezza. Sbagliando. E lo trovi solo se conosci il dominio abbastanza bene da accorgerti che quel numero è assurdo.
I numeri, due mesi dopo
- 1.034 sassi registrati
- 264 persone iscritte
- 2.392 tappe di viaggio tracciate
- 51.022 km percorsi complessivamente
- 490 sassi attualmente in giro, in attesa di essere trovati
- 357 ritrovamenti confermati con il codice fisico
- 64 changelog, uno per ogni rilascio, dalla 0.1.0 alla 2.30.0
La cosa che mi ha sorpreso di più non è il picco, ma la costanza. Le iscrizioni settimanali dopo il primo mese si sono stabilizzate intorno a 30/40 persone, senza campagne e senza budget: 46 nella settimana del 9 agosto, 34 in quella del 16 poi 30, 34, 31, 37. Una curva piatta ma viva, che è molto più rassicurante di un picco seguito dal nulla. I sassi seguono lo stesso ritmo: tra i dieci e i venti nuovi al giorno, tutti i giorni.
La parte che non avevo previsto
E poi ci sono i casi singoli. Che sono la ragione per cui questa cosa esiste, e che non avevo previsto per niente. Quando progetti il campo note di una tabella, lo pensi come a un campo di testo. TEXT, nullable, facoltativo. Nel documento di progetto l'avevo scritto esattamente così, in mezzo agli altri: coordinate, foto, nota, firma del finder. Una riga tra le righe.
Poi la gente ha iniziato a scriverci dentro. "Sognando" è un sasso lasciato su una panchina a Monza il 3 settembre. Il giorno dopo qualcuno lo trova e lascia questa nota:
In un giorno particolare, sono in ospedale per Pet mio papà, lo trovo sulla panchina. Voglio pensare mi porterà fortuna ❤️
Barbara se l'è tenuto. Il sasso è uscito dalla mappa quel giorno stesso, fine del viaggio. Tecnicamente è un record che smette di comparire in una query. In pratica è una persona che aspettava fuori da una sala d'attesa e ha trovato una ragione per sperare.
"Il faro", lasciato a Seveso il 15 settembre, porta scritta dietro una frase del suo creatore: "Il faro resta immobile mentre l'estate sbiadisce. La sua luce continua a tagliare il buio." Viene trovato lo stesso giorno:
Questo è un periodo difficile per me, e trovare questo sasso e il suo messaggio è stato un "faro" nella notte. Grazie, bellissimo! 🤍
Chi ha dipinto quel sasso non conosceva Federica. Ha scritto una frase su un sasso e l'ha lasciata su un muretto, e quella frase è arrivata esattamente alla persona che ne aveva bisogno, lo stesso giorno. Nessun algoritmo di raccomandazione, solo un sasso su un muretto.
Amy, e un sasso arrivato a Shanghai
Ma la storia che mi ha fatto capire davvero cosa avevo costruito (e anche piangere un pò) è quella di "Armonie di colore" — il sasso che ha percorso 10.704 chilometri.
La descrizione che gli ha messo il creatore è questa:
Per la mia piccola Amy, nel suo posto preferito ❤️ che viaggi per il mondo 🌍
Viene lasciato il 26 luglio a Portoferraio, all'Isola d'Elba. Tre giorni dopo lo trova Viktor, che scrive in tedesco — "Wonderfoul 😍 Was für eine schöne Initiative!" — e lo riporta a Marsiglia.
Il primo agosto lo trova Luukë, in porto, e la nota arriva in cinese. Tradotta: "All'inizio pensavo fosse qualcosa dimenticato da un passeggero del porto, poi ho guardato dietro e sono rimasto affascinato da questo progetto! Quando torno a casa lo farò senz'altro con il mio piccolo." Lo porta a casa. Casa è Shanghai.
Il 6 agosto lo trova Lu: "L'ho trovato vicino a Central Park. Ho scoperto che questo sasso viene dalla bellissima Italia e dalla Francia! Non ho molte occasioni di viaggiare, ma mi piacerebbe portarlo qui vicino!" Poi ancora una tappa, e un'altra: distretto di Binhu, poi Xiangyang. In diciassette giorni: Elba → Marsiglia → Shanghai → Xiangyang. Tre lingue, sei persone, nessuna delle quali si conosce. Poi il colpo al cuore. Il creatore commenta sul diario del sasso e scopriamo che quel sasso era dedicato a una persona che non c'è più, e che Shanghai era il posto che avrebbe voluto visitare.
Questo non lo puoi progettare. Non c'è una user story che dice "come utente, voglio che il sasso dedicato a mia figlia arrivi nella città che lei sognava". Non c'è un test che lo copre, non c'è una metrica che lo misura. Io ho costruito una tabella rock_events con un campo note , e qualcun altro ci ha messo dentro il significato.
Quello che questo ha cambiato nel codice
Detta in modo meno poetico e più professionale: nel momento in cui capisci che quel campo di testo contiene quella roba lì, cambiano le priorità tecniche. Le note del diario non sono più un dettaglio accessorio, sono il prodotto. Da cui è derivato, nelle settimane successive, tutto un filone di lavoro che nel piano iniziale non esisteva: la moderazione dei contenuti, la possibilità per il creatore di rispondere sul diario, la geocodifica inversa delle coordinate per scrivere "Marsiglia" invece di 43.2965, 5.3698, la timeline accorpata per trovatore, le notifiche push per non far scoprire una cosa così tre settimane dopo.
E anche una decisione difensiva: chi scrive quelle note non ha un account. Non posso contattarlo, non posso chiedergli conferma, non posso bannarlo in modo significativo. Quella scelta di prodotto presa il primo giorno (finder sempre guest) ha il suo prezzo, e si paga qui. La moderazione doveva funzionare su contenuti anonimi, e l'ho dovuta costruire di conseguenza.
L'AI mi ha aiutato a scrivere tutto questo in fretta. Ma nessuna AI mi avrebbe detto che quel campo TEXT nullable era la cosa più importante del database. L'ho capito leggendo la nota di Barbara. Nel frattempo il progetto è cresciuto ben oltre il brief iniziale: contest a tema, sistema di follow, commenti moderati, notifiche push, achievement calcolati, un'area business, API per l'app nativa (che non so se mai pubblicherò, per i motivi citati prima), e una pipeline editoriale. Circa 90 migrazioni, quasi 200 classi PHP. Tutto questo in due mesi, lavorandoci nei ritagli di tempo, nei weekend, le notti, massimo 2h a notte.
Cosa mi porto a casa
L'AI non mi ha reso uno sviluppatore migliore. Mi ha reso uno sviluppatore più veloce, il che è una cosa diversa e va detto con precisione. La velocità serve a qualcosa solo se hai già le risposte alle domande che contano: come sono fatti i dati, cosa può falsificare un utente malintenzionato, dove le persone abbandonano un flusso, quale bug è un fastidio e quale è un difetto strutturale. Quelle risposte non stanno in un prompt. Stanno in quindici anni di cose che sono andate storte.
Quello che l'AI toglie è il tempo di battitura: le migrazioni, i controller CRUD, le viste ripetitive, il boilerplate delle mail. In un progetto come questo è la maggioranza delle righe scritte e la minoranza delle decisioni prese. Delegarla non è barare: è smettere di pagare una tassa che non produce valore.
Quello che resta tuo è tutto il resto. E si vede: se apri il codice di SassoGo, quasi ogni classe ha in testa un commento che spiega perché è fatta così — non cosa fa. Perché il TTL è di due ore. Perché la compressione forte avviene una volta sola. Perché il messaggio d'errore nomina due sistemi operativi. Perché l'elenco troncato deve portarsi dietro il totale. Perché la moderazione oscura senza cancellare, e perché i messaggi privati restano fuori dalla whitelist. Quei commenti sono la parte umana del progetto. Sono le decisioni. Il codice intorno è esecuzione — importante, necessaria, ma mera esecuzione.
Tre giorni invece di tre mesi non significa che il pensiero sia stato compresso da tre mesi a tre giorni. Significa che il pensiero c'era già, e per la prima volta non ho dovuto aspettare le mie dita per verificarlo. C'è però una cosa che ho imparato dopo, e che vale più di tutto il resto. Passi settimane a decidere gli stati, a proteggere un codice di quattro caratteri, a scegliere un TTL di due ore invece che di ventiquattro. Sono decisioni giuste, e senza quelle il prodotto non starebbe in piedi. Ma la parte che conta davvero non l'hai progettata tu: è arrivata da una signora in un ospedale di Monza, da un ragazzo in un porto di Marsiglia che scrive in cinese, da un padre che scopre che il sasso dedicato a sua figlia è arrivato dall'altra parte del mondo.
Il lavoro dello sviluppatore (con l'AI o senza) è costruire il posto dove quel genere di cose può succedere. E poi togliersi di mezzo.
SassoGo è online su sassogo.it. Se trovi un sasso dipinto con un codice dietro, ora sai cosa farne.
Ho scritto questo articolo in più giorni, e ogni giorno, per tutte le storie che ho raccontato qui, mi sono commosso, ho pianto, ho riso, e mi è anche venuta in mente qualche idea da integrare.
Buona giornata/nottata a tutti quelli che sono arrivati fino a qui,
Un abbraccio,
Dave